我把自己变成了韩剧男主角,并在风之丘拍了一场戏:完整的 AI 流程
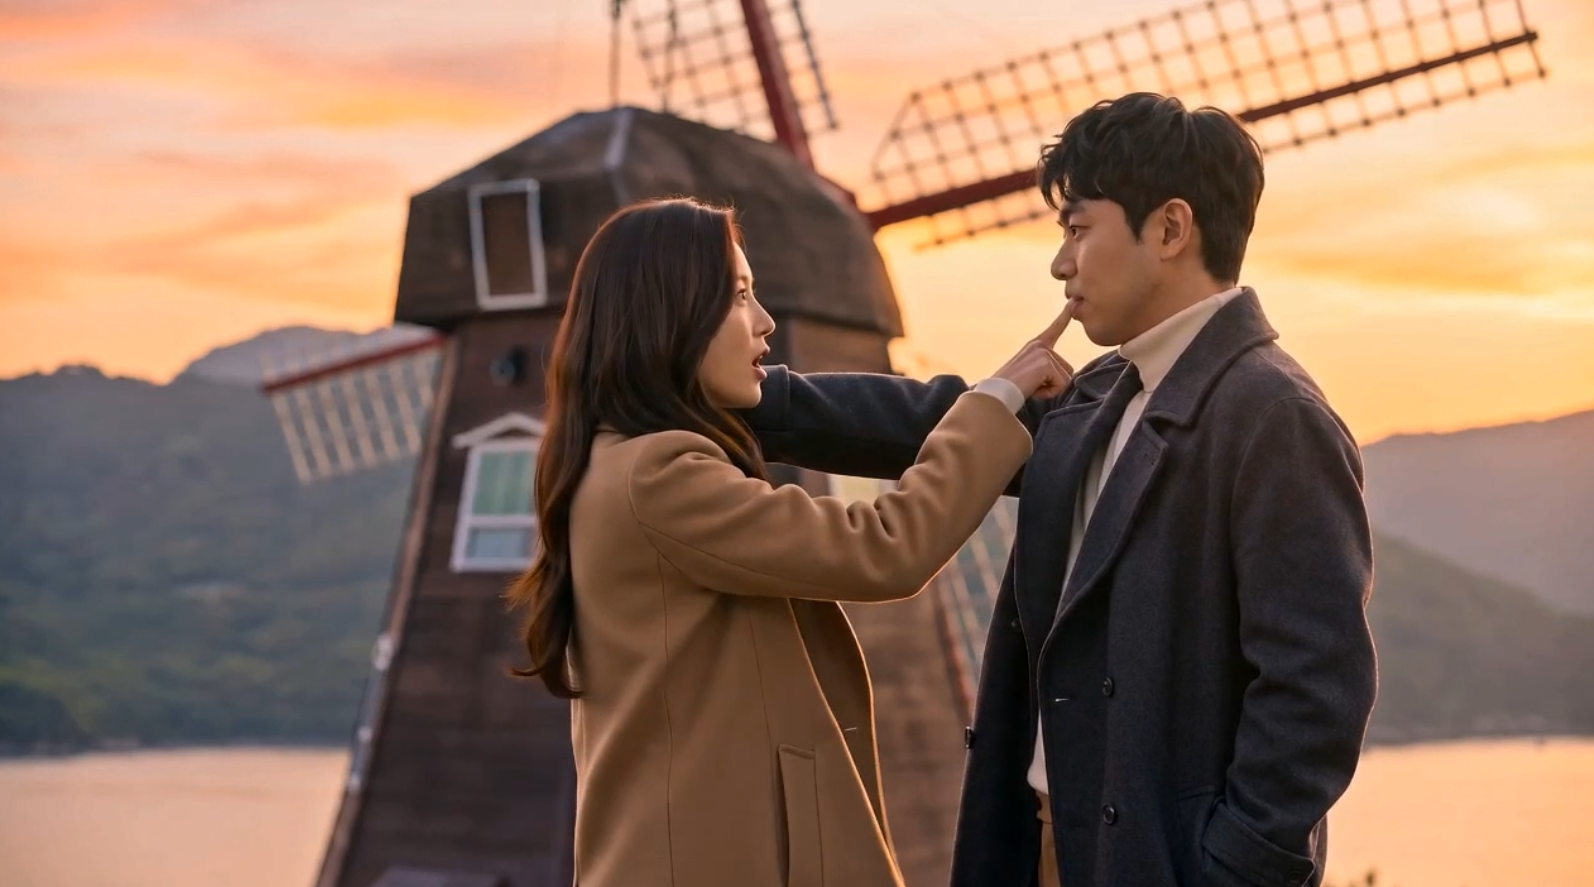
我想看看,一场完全由 AI 生成的韩剧场景,能被推到什么程度、从头到尾:我自己担任男主角,一位虚构的女主角,在韩国的一处真实地点实景拍摄,一段完整的多镜头序列,还带一个反转结局。没有摄像机,没有演员,没有踩点,只用 Nano Banana Pro 做静态图,用 Seedance 2.0 做视频。
我特别想测试三件事:
- 亲手体验多镜头场景生成。一条提示词,真的能导演出一段包含多个机位和剪辑结构的完整小场景,而不只是一个连续的片段吗?
- 单次生成内的角色一致性。同样的两个人,在一次生成的五个不同机位里,还能被一眼认出是他们吗?
- 单次生成内的场景/地点一致性。真实世界的地点(风车、木栈道、海)能在剪辑切换之间保持几何上的一致,而不是飘移吗?
下面是整个过程,包括所有不完美的地方。
第 1 步:创建角色
第一站是角色设定图,这是下游一切工作所依赖的参考素材。
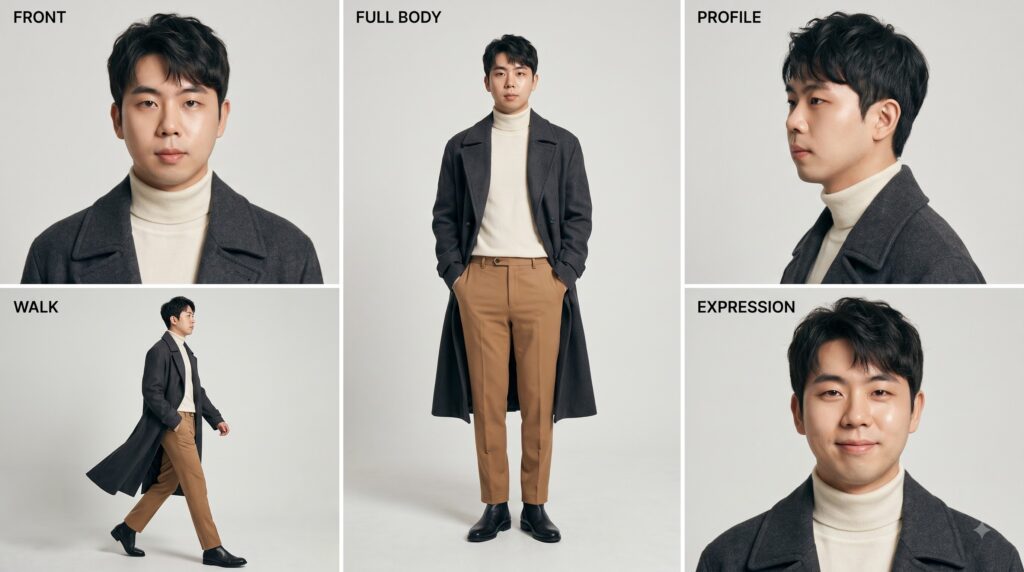
对于男主角,我用自己的照片作为身份参考,让 Nano Banana Pro 生成一张 5 格的角色设定图:正面、四分之三侧面、全身、行走姿态,以及一个特写表情。这里最重要的技巧,是明确锁定服装。我第一次尝试时,让模型在两套服装方案之间自行选择,结果它高高兴兴地在每一格里给了我不同的外套。点明具体的衣物(炭灰色羊毛风衣、奶油色高领毛衣、驼色长裤),并把“每一格都完全一样”这条指令重复两次,才解决了这个问题。
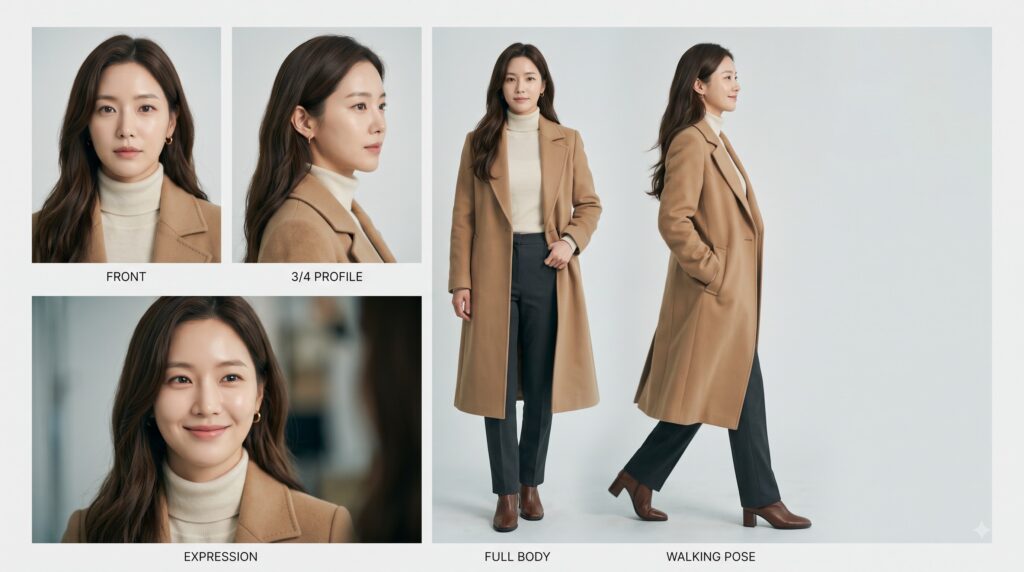
对于女主角,由于没有参考照片,我必须在一开始就把面部特征(脸型、眼睛大小、发质)描述得明确得多,才能让她在同样的 5 格版式里保持可辨认,并且让她的服装语言与他匹配(同一色板:炭灰、奶油、驼色),这样两个人合成在一起之后,在视觉上才像是属于同一部剧。
第 2 步:选择地点
关于场景,我选了巨济岛的风之丘(바람의 언덕),这是一处真实、著名的韩剧取景地,长满青草的悬崖上有一座标志性的木质风车,俯瞰着大海。我没有从零开始生成场景,而是在网上找了一张这个地点现成的照片,直接用作我的基础底图。不需要地点参考设定图,因为这张真实照片已经包含了我想围绕它搭建场景的确切角度、木栈道和构图。
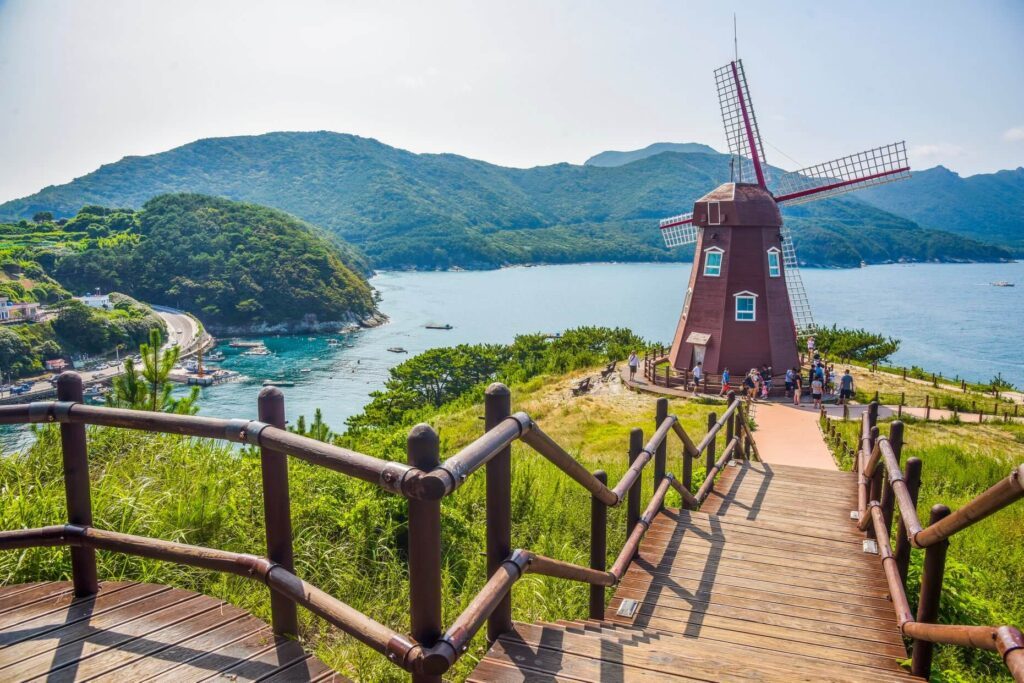
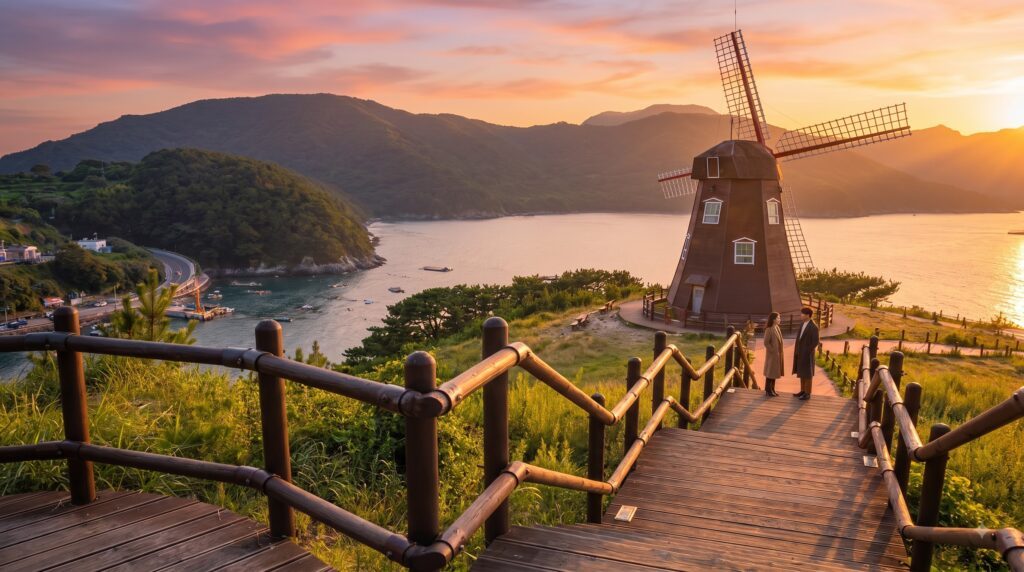
第 3 步:把这对情侣合成进场景
有了角色设定图和一张干净的地点底图,接下来是合成:把两个角色放进这张真实照片里,放在我用红色 X 在木栈道上标出的特定位置,两人面对面,重新打光成日落(原照片是正午拍的),并且去掉背景里真实的游客。
第 4 步:为多镜头序列写剧本
目标 #1 就是在这里真正接受测试的。我在社交媒体上看到不少人在做这种单次生成、多镜头的 AI 视频序列,我想亲自试一试,而不是退回到更显而易见的路线:生成五个独立的片段,再到剪辑软件里拼起来。事实证明,Seedance 2.0 支持把整个多镜头序列写成一条带时间戳的提示词,在一次连续的生成里,机位之间有真正的硬切。
有效的格式,是把它组织得像一份真正的拍摄脚本:
[Action Sequence]
SHOT 1 (0:00–0:04) ...
SHOT 2 (0:04–0:07) ...
SHOT 3 (0:07–0:10) ...
SHOT 4 (0:10–0:13) ...
SHOT 5 (0:13–0:15) ...
[Production Brief]
References: @Image 1 = location, @Image 2 = male character, @Image 3 = female character...
Continuity: [what stays fixed across every shot]
Forbidden: [everything that kept going wrong, listed explicitly]
故事节拍是:情侣站在风车前的全景建立镜头,用慢动作过肩镜头营造浪漫的张力,然后一个生硬的气氛转折,男生没有说浪漫的话,反而用一句傻乎乎的“거제 야호!”破坏了气氛,接着女生用手指按住他的嘴唇让他闭嘴,同时叫他别吵了。
第 5 步:调试循环
大部分真正的学习都发生在这里,说实话,目标 #2 和 #3 也在这里受到了最严苛的压力测试。大致按我遇到的顺序:
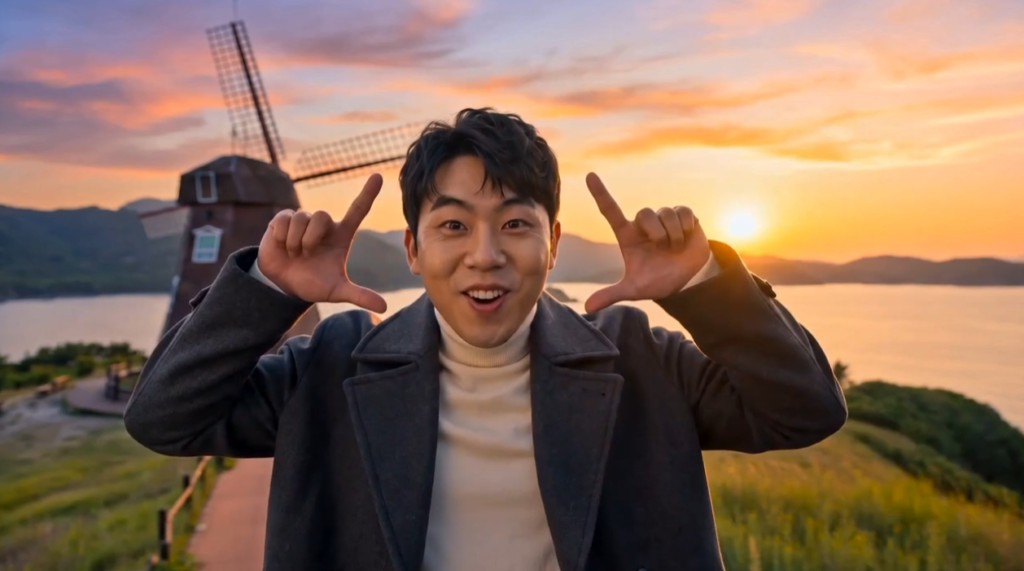
- 风车跑到了他身后,而本来不该这样。这个镜头本该是面对男主角,他身后没有风车,但在其中一次迭代里,他的朝向稍微偏移了,因为机位绑定在他的视角上,机位随之偏移,结果风车就正好出现在他的身后。值得一提的是,场景环境本身(风车、地点)在整个过程中保持得相当一致。这更多是角色朝向改变带来的连锁反应,而不是环境自己在飘移。
- 用最痛的方式学到的 180 度轴线规则。我的过肩镜头一开始在序列中途换了机位所在的肩膀,这是任何电影剪辑师都会立刻发现的连续性错误。我不得不为每个镜头明确固定一个机位侧,并声明两个镜头都保持在两个角色之间那条轴线的同一侧。
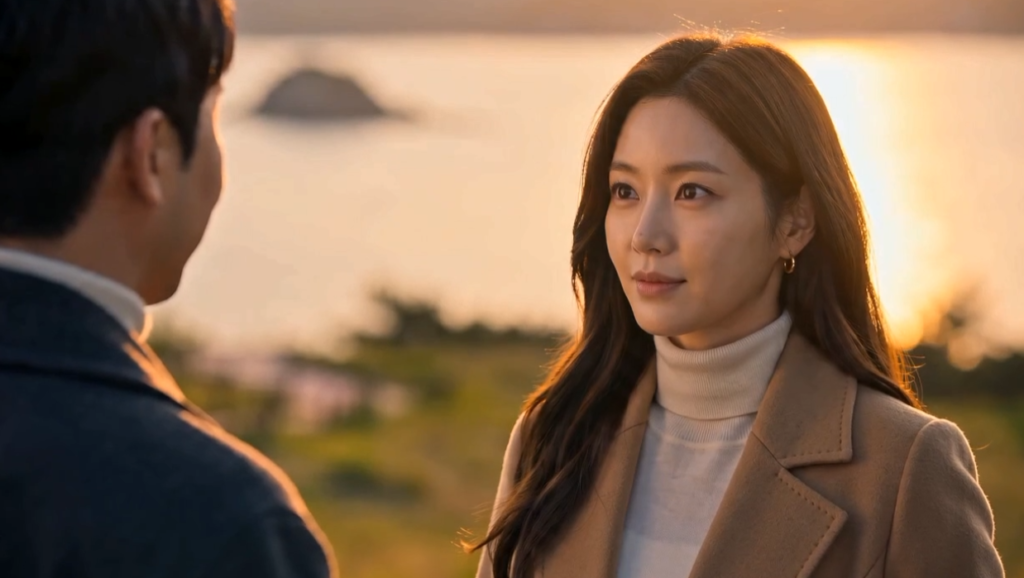
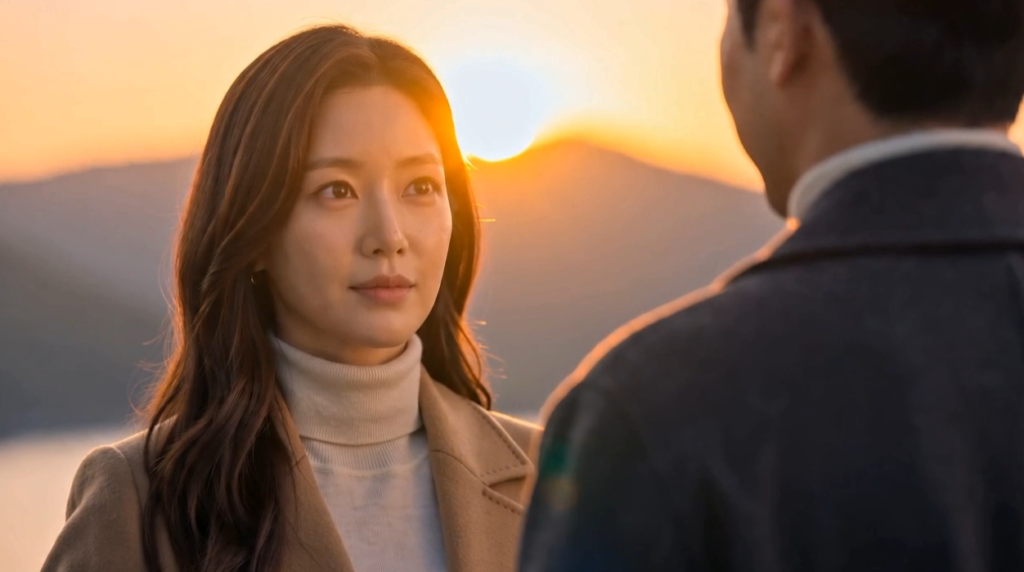
- 不可能的物理。太阳出现在了对话的两个反打镜头里,而当两个人面对面、其中一个镜头朝向太阳时,这是不可能发生的。我不得不明确声明,太阳绝对不能出现在反打角度里,并描述那个角色是被环境反射光照亮的。
- 内容审核。我最初的反转是她打他一巴掌。这被标记为违反社区准则,很可能是因为打脸被判定为描绘暴力。我改成了她用手指按住他的嘴唇让他闭嘴,这既保留了喜剧节拍,又显得俏皮而不是有攻击性。
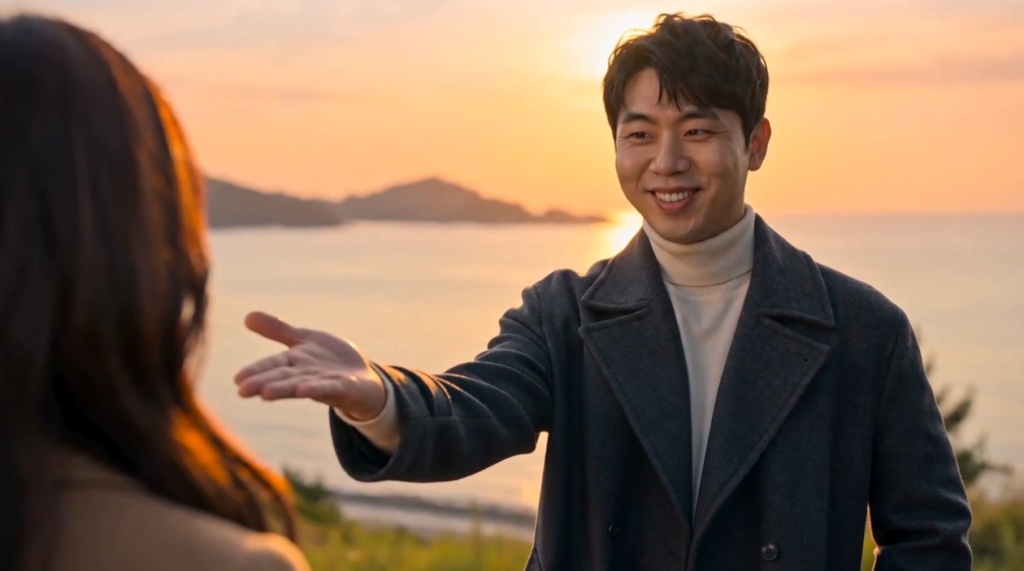
- 始终没有完全到位的手势。这是最难的一个。我想让他做一个故意很土的“倒过来的剪刀手”(手心朝上、手指下垂),同时喊着“거제 야호!”。我每一次用文字描述它,出来的都是别的东西:先是一个双手比的数字 7 手势,然后是一个平摊的手掌。最后,我给它喂了一张真实的手朝镜头做类似 V 字手势的参考图,来锁定形状,这帮助了手臂的位置,但依然没能完全做到那个精确的倒置朝向。
结果(以及我最后的落点)
我始终没有得到最初想要的那个精确的“倒置 V 字、手心朝上”的手势。最终出来的,是他的手臂平行于地面伸出,手指比成张开的 V 字,但手心朝下而不是朝上。我决定顺势接受:现在的设定是,这个人是个过时的大叔(아저씨),把潮流搞错了一点点,做的是一个不规范的、倒过来的剪刀手,而不是他以为自己在做的那种撒娇手势。说实话,它依然很好笑,只是笑点和原计划的略有不同。
反思
这里最大的收获是目标 #1:把整个场景作为一次多镜头生成来完成,而不是五个独立的片段。它更快(不需要为每个单独的镜头生成首帧/尾帧),连续性几乎是白送的。因为整段序列是一次生成,同样的动作和能量会从一个镜头延续到下一个镜头,这是你在剪辑软件里拼接各自独立生成的片段时,很难伪造出来的。
但同样的优势,也是它的天花板。像倒置剪刀手这样复杂、具体的肢体动作,似乎是模型没有被强力“训练”成一个可辨认的形状的情况,无论我多精确地描述手指的位置和手腕的旋转。一个普通、寻常的剪刀手几乎肯定一次就能成功。对于这类真正不寻常或要求精确的肢体动作,我认为,逐镜头生成并配合首帧/尾帧控制,或者一段真实动作的参考视频,会比单靠文字去“描述”一个不常见的手势出来,能给你多得多的控制力。
所以:凡是流畅度和连续性比某个具体动作的精确度更重要的情况,就用一次生成的多镜头。凡是某一个非常具体的肢体细节必须完全到位的情况,就用逐镜头生成,配合强力的帧/视频参考。